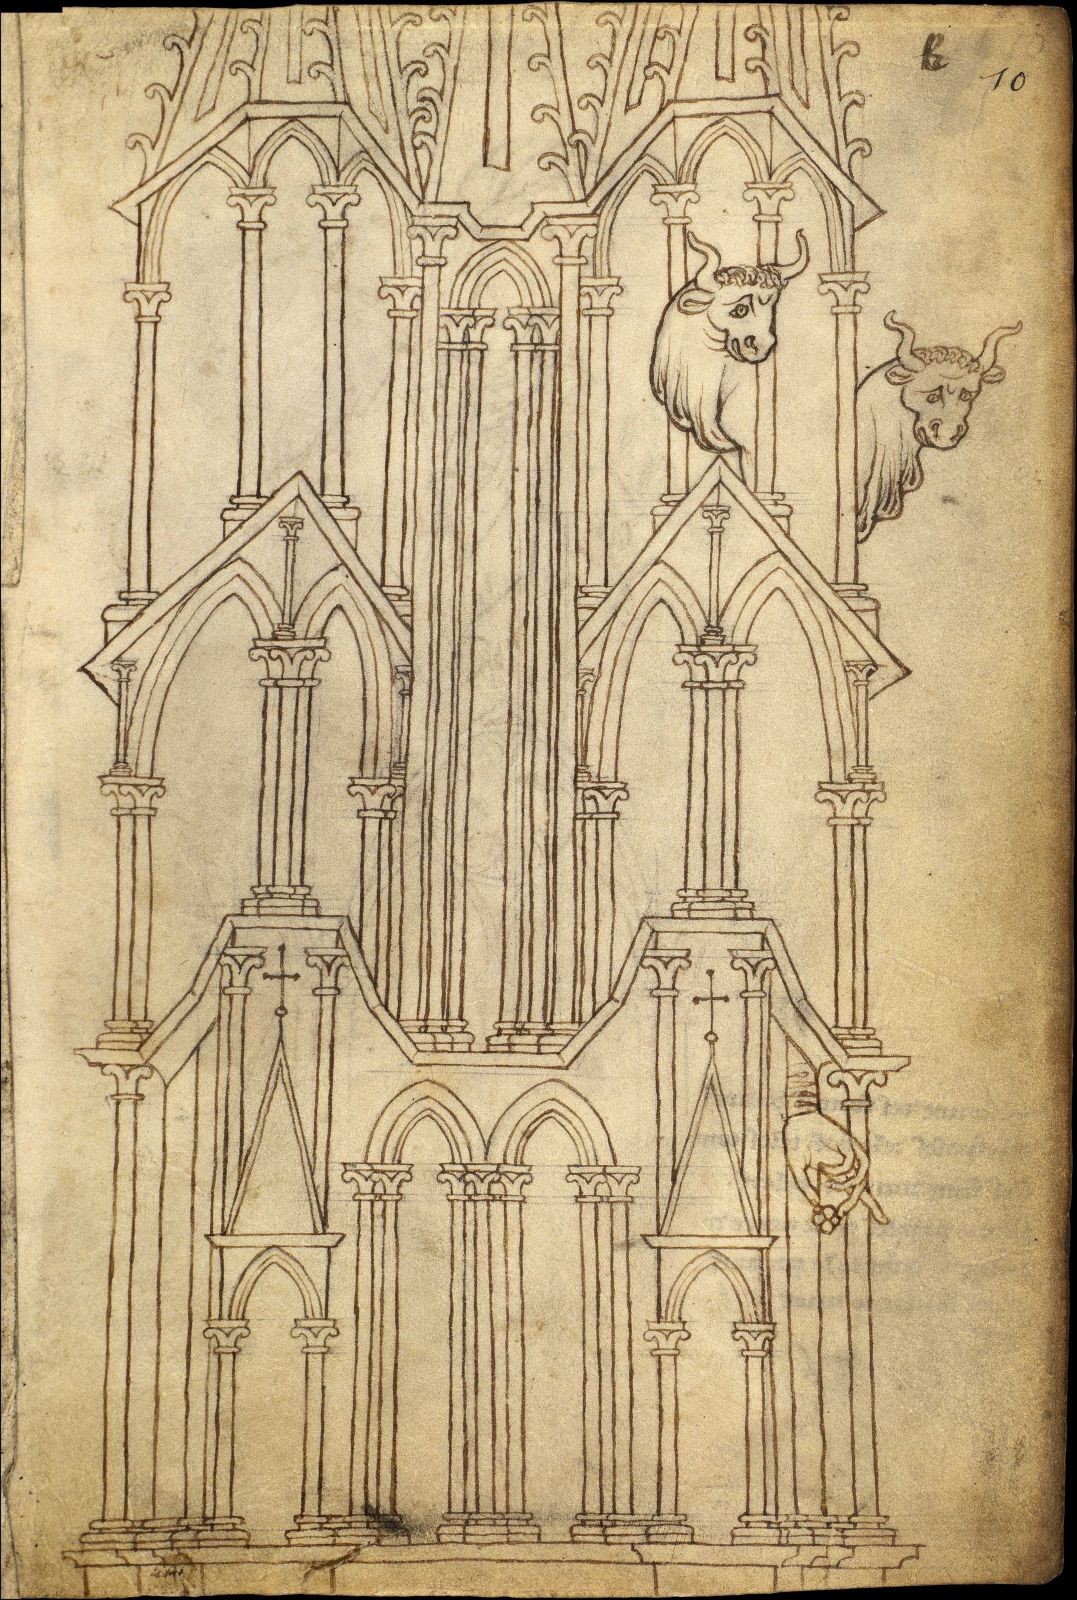
L’un des apports les plus décisifs de l’intelligence artificielle à l’architecture n’est ni la vitesse d’exécution, ni la génération d’images spectaculaires, mais la possibilité de construire ce que les chercheurs appellent un espace latent : un espace mathématique où les formes, les proportions, les matériaux et les usages d’un corpus architectural sont représentés sous forme de relations continues.
NB : Cet article s’appuie sur un ensemble de retours recueillis auprès de collègues ABF autour des usages et des enjeux de l’IA dans nos pratiques. Il propose une synthèse collective, complémentée à l’aide de Chat GPT, rédigée et structurée par France Chapron et Marc Louail.
Cet espace, décrit par Kingma & Welling1 (2014) pour les auto-encodeurs variationnels et largement développé depuis dans les modèles génératifs (Goodfellow et al., 20142 ; Radford et al., 20153 ), constitue un objectif central pour quiconque s’intéresse à la manière dont une machine peut “comprendre” la morphologie d’un territoire.
Appliqué au patrimoine bâti, l’espace latent n’est pas un atlas d’images, mais une géométrie statistique capable de rendre compte de la cohérence interne d’un tissu urbain : pentes de toiture, modénatures, distributions d’ouvertures, rapports pleins-vides, signatures stylistiques. Il devient alors possible d’envisager que l’instruction des projets —qui repose largement sur la reconnaissance de ces régularités— puisse être partiellement outillée par des modèles apprenants.
Cet article propose une lecture prospective —mais non fictionnelle— de cette transformation. D’abord en exposant les concepts fondamentaux des machines apprenantes et de l’espace latent, tels que décrits par la littérature scientifique récente ; ensuite en montrant comment ces concepts permettraient, demain, d’outiller l’instruction des demandes d’autorisation dans les secteurs patrimoniaux ; enfin en esquissant les effets d’une telle évolution sur les pratiques collectives des UDAP, non comme un changement de métier, mais comme un déplacement de l’attention vers le cœur du travail : l’analyse, le jugement, la médiation.
L’évolution des outils de conception : de la représentation manuelle à la modélisation apprenante
Du geste vernaculaire à la naissance de la représentation
Avant d’être un champ théorique ou technologique, l’architecture est d’abord un art vernaculaire, façonné par les matériaux disponibles, les climats, les savoir-faire locaux et les gestes transmis oralement. Le maître d’œuvre médiéval n’exprime pas un projet ; il prolonge un répertoire partagé. Ce n’est qu’avec les premiers recueils graphiques -les carnets de Villard de Honnecourt ou les épures tracées sur les aires de chantier— que s’amorce une véritable formalisation du projet. Antoine Picon, dans La ville et la technique4 , analyse ce moment comme la naissance d’un langage graphique autonome, capable de décrire ce qui n’existe pas encore. Mario Carpo, dans The Alphabet and the Algorithm (2011)5 , voit dans cette évolution le premier déplacement d’un « art du faire » vers un « art du représenter ».
Cette transition installe l’idée que l’architecture peut être conçue hors de sa matérialité immédiate —un préalable indispensable à toute forme de modélisation.
La révolution numérique : du trait à l’algorithme
Ce glissement du geste vers la trace ouvre la voie, plusieurs siècles plus tard, à une seconde rupture : l’entrée dans le numérique. Au XXe siècle, la ligne cesse d’être une empreinte manuelle pour devenir un objet manipulable.
Sketchpad d’Ivan Sutherland (MIT, 1963) inaugure cette ère où la géométrie devient interactive ; les travaux de Pierre Bézier chez Citroën (UNISURF, 1968) inventent les courbes qui rendront possible le design contemporain.
Les années 1980–1990 voient l’essor de CATIA, AutoCAD, et plus tard du BIM, qui consolident une chaîne de production entièrement basée sur la géométrie : l’architecture se formule désormais dans un espace vectoriel, piloté par une logique algorithmique où chaque trait est défini, paramétré, calculé.
Le paramétrisme : la règle comme générateur de forme
À partir des années 2000, les environnements Grasshopper, Rhino, 3ds Max permettent d’articuler la géométrie à des régimes paramétriques. La règle devient la matrice de la forme. Patrik Schumacher6 , dans The Autopoiesis of Architecture (2008), systématise cette idée : la forme architecturale n’est plus le produit d’un dessin, mais la conséquence d’un système de relations explicites. La géométrie cesse d’être représentée pour devenir générée.
Cette période reste néanmoins une époque de règles explicites :
→ l’architecte programme ;
→ le logiciel exécute.
Le tournant des machines apprenantes
C’est pourtant ici qu’apparaît la rupture décisive qui nous intéresse : l’entrée dans l’ère du machine learning. Contrairement à l’algorithmique ou au paramétrique, l’apprentissage profond ne repose plus sur la définition préalable de la règle. Il procède à rebours : la règle est déduite, non écrite.
Comme l’ont formulé Ian Goodfellow, Yoshua Bengio et Aaron Courville dans Deep Learning (MIT Press, 2016), le deep learning remplace les « caractéristiques fabriquées à la main » par des « représentations hiérarchiques apprises à partir des données ».
C’est ce mouvement inductif que résume magistralement l’article de Yann LeCun, Bengio et Hinton dans Nature7 (2015) : l’architecture computationnelle devient capable d’extraire elle-même la manière d’observer, de classer et de modéliser un corpus. Avec cette mutation, la conception numérique ne repose plus sur un principe déterministe ; elle devient statistique, probabiliste, inductive.
De la chaîne graphique à la chaîne apprenante
Ainsi, en l’espace de quelques décennies, la conception a glissé d’une chaîne graphique (fondée sur la trace), à une chaîne algorithmique (fondée sur la règle), puis à une chaîne apprenante (fondée sur la donnée).
C’est dans cette dernière que s’inscrit aujourd’hui le travail sur l’espace latent, comme la conséquence logique d’une histoire où l’intelligence de la forme se déplace progressivement de la main vers la règle, puis de la règle vers la statistique.
Comprendre une machine apprenante : données, modèles et espace latent
Le processus d’apprentissage statistique : extraire les singularités de la donnée
Si le machine learning marque une rupture, c’est parce qu’il introduit une nouvelle manière d’observer le réel. Là où l’architecture paramétrique reposait sur un système de règles explicites, l’apprentissage automatique procède par induction : il collecte, compare, discrétise, hiérarchise. Aucun modèle n’est programmé a priori ; il se forme par l’exposition répétée à des données, selon un cycle par étapes :
- Collecte massive de données : images, plans, relevés, corpus textuels ;
- Encodage statistique : extraction des caractéristiques pertinentes ;
- Classification/discrétisation : organisation en catégories latentes.
- Modélisation probabiliste : apprentissage de la variation interne
Qu’il s’agisse d’immeubles, de typologies de plan, de modénatures de façade ou de répertoires de matériaux, le processus reste identique : la machine identifie ce qui se répète, ce qui varie, ce qui distingue et construit sa propre grammaire du regard. Chaque couche y apprend une représentation plus abstraite que la précédente : d’abord des motifs élémentaires, puis des structures intermédiaires, puis des organisations complètes du bâti. C’est ce principe hiérarchique qui distingue le machine learning classique —dépendant d’une sélection manuelle8 des caractéristiques— du deep learning, où la profondeur du réseau permet à la machine de construire elle-même les niveaux successifs d’abstraction nécessaires à la compréhension d’un corpus.
Dans les travaux de David Blei9 (Probabilistic Topic Models, 2012), cette logique relève d’un apprentissage thématique probabiliste : les motifs latents émergent non par décision, mais par agrégation statistique. Yann LeCun, dans sa conférence Representation Learning (Harvard, 2016), en fait même la condition préalable à toute forme d’intelligence : apprendre à représenter, avant d’apprendre à décider.
Le neurone formel : la brique élémentaire de l’apprentissage profond
L’apprentissage profond repose sur une abstraction extrêmement simple : le neurone formel, défini dès 1943 par McCulloch et Pitts10 , puis reformulé par Rosenblatt11 dans son Perceptron (1957–1958). Ce neurone n’est pas une imitation biologique ; c’est une unité mathématique qui reçoit un ensemble de signaux, les pondère, puis produit une sortie.
Un modèle n’est alors rien d’autre qu’un réseau de ces unités élémentaires —ce que la littérature nomme un réseau de neurones. L’innovation du deep learning ne tient pas dans le neurone lui-même, mais dans la possibilité d’en empiler des milliers, organisés en couches successives, chacune apprenant une représentation plus abstraite que la précédente.
C’est ce que résument LeCun, Bengio et Hinton dans leur article fondateur publié dans Nature en 2015 : une architecture profonde apprend d’abord des motifs simples (bords, textures), puis des structures intermédiaires (travées, modénatures), puis des organisations de haut niveau (typologies, styles, régularités morphologiques).
La machine n’imite pas le regard humain : elle apprend à produire un espace où le réel devient mesurable, comparable, navigable.
L’espace latent : une bibliothèque continue des possibles
Au cœur de ce processus se trouve le concept d’espace latent, introduit par Kingma & Welling (2014) à travers les auto-encodeurs variationnels, puis largement diffusé par les travaux de Radford et al. sur les GANs (2015).
Dans cet espace mathématique :
- ce qui se ressemble est proche,
- ce qui diffère est distant,
- un point correspond à une instance possible (forme, matériau, typologie).
Cet espace est structuré selon des axes sémantiques —profondeur, hauteur, rythme, rapport pleins-vides, orientation, matériau— qui permettent d’exprimer la variété interne d’un ensemble. Chaque forme, chaque proportion, chaque signature stylistique d’un corpus est projetée sous forme de coordonnées continues. Une façade, un plan, une toiture, une typologie constructive, n’y apparaissent plus comme des objets isolés, mais comme des positions dans un continuum de relations. Deux objets s’y trouvent proches lorsqu’ils partagent des caractéristiques ; ils s’en éloignent lorsqu’ils s’en distinguent.
Pour Mario Carpo, dans The Second Digital Turn12 (2017), cet espace constitue un “réservoir computationnel” : une bibliothèque de variations où la forme n’existe qu’en relation avec d’autres formes, dans une continuité qui évoque autant la théorie architecturale que la statistique.
Le prompt comme interrogation d’un espace latent
Contrairement à ce que suggère la vulgarisation, le prompt n’est pas une commande mais une sélection probabiliste d’un point dans l’espace latent.
Les travaux récents de Touvron13 et al. (LLaMA 2 & 3, MetaAI, 2023–2024) montrent que le langage n’agit pas par injonction, mais par aiguillage des distributions internes du modèle. Le texte désigne une région de l’espace latent ; le modèle y choisit un point probable ; la représentation générée en découle.
Cette logique a été théorisée par Liu et al. dans Pre-train, Prompt, Predict (ACL, 2021)14 : le prompt est une méthode d’alignement statistique, non une commande impérative. Autrement dit, on ne demande pas une image : on demande à naviguer dans un espace préalablement appris.
Échelle : les limites du signal lorsque le territoire grandit
Si le deep learning est puissant, il n’est pas universel. À mesure que l’échelle augmente —du détail constructif au bâtiment, puis du bâtiment au quartier— le signal statistique se dilue.
La raison est simple :
- plus l’échelle est large, plus la donnée est hétérogène,
- plus les régularités deviennent floues,
- plus la machine confond ce qui est essentiel et ce qui est contingent.
Cette difficulté, que la recherche contemporaine aborde sous l’angle du multi-scale learning, rejoint les intuitions formulées dès les années 1990 par Neil Postman15 dans Technopoly : un système technique qui agrège trop d’informations tend à perdre la capacité d’interpréter le contexte.
Pour l’architecture patrimoniale, cette limite est centrale : la cohérence d’une façade ne s’analyse pas selon les mêmes critères que la cohérence d’un tissu urbain. L’espace latent doit être pensé à l’échelle pertinente.
Pour lire la suite de l’article, cliquer ici
- Kingma, Diederik, Max Welling. Auto-Encoding Variational Bayes, 2014. ↩
- Goodfellow, Ian, Yoshua Bengio, Aaron Courville. Deep Learning. MIT Press, 2016. ↩
- Radford, Alec et al. Unsupervised Representation Learning with Deep Convolutional GANs, 2015 ↩
- Picon, Antoine. La Ville et la Technique. Parenthèses, 1998 ↩
- Carpo, Mario. The Alphabet and the Algorithm. MIT Press, 2011 ↩
- Schumacher, Patrik. The Autopoiesis of Architecture. Vol. 1. Wiley, 2011 ↩
- LeCun, Yann, Yoshua Bengio, Geoffrey Hinton. “Deep Learning”, Nature, 521, 2015. ↩
- LeCun, Yann. Representation Learning, Harvard Colloquium, 2016 ↩
- Blei, David. Probabilistic Topic Models, Communications of the ACM, 55(4), 2012. ↩
- McCulloch, Warren, Walter Pitts. A Logical Calculus of the Ideas Immanent in Nervous Activity, 1943 ↩
- Rosenblatt, Frank. The Perceptron, Psychological Review, 1958 ↩
- Carpo, Mario. The Second Digital Turn : Design Beyond Intelligence. MIT Press, 2017. ↩
- Touvron, Hugo et al. LLaMA 2 et LLaMA 3, MetaAI, 2023–2024 ↩
- Liu, Pengfei et al. Pre-train, Prompt, Predict, ACL 2021. ↩
- Postman, Neil. Technopoly : The Surrender of Culture to Technology. Vintage, 1992. ↩
